ChatGPTやGoogleのAI検索に自社サイトを出したいとき、robots.txtで確かめる3つのこと


ChatGPTやGoogleのAIに質問したとき、その答えの中に自社のホームページが出てきてほしい。そう考えたときに、最初に確かめておきたいのが「robots.txt」というファイルです。ここで検索用のクローラーを止めていると、どれだけ記事を書いても、AIの検索には読んでもらえません。
この記事では、GoogleとOpenAIが公開している資料をもとに、robots.txt で確かめることを3つに分けて整理します。本文の内容は、2026年11月17日に各社の公式ページで確認したものです。
結論:AIの検索に出したいなら、Googlebot と OAI-SearchBot を止めていないかを確かめます
GoogleのAIによる概要(AI Overviews)やAIモードは、ふだんのGoogle検索と同じ仕組みの上で動いています。Googleは、これらに表示されるための追加の要件や、特別な最適化は必要ないと説明しています。Googlebot がページを読めて、検索に出られる状態になっていれば足ります。
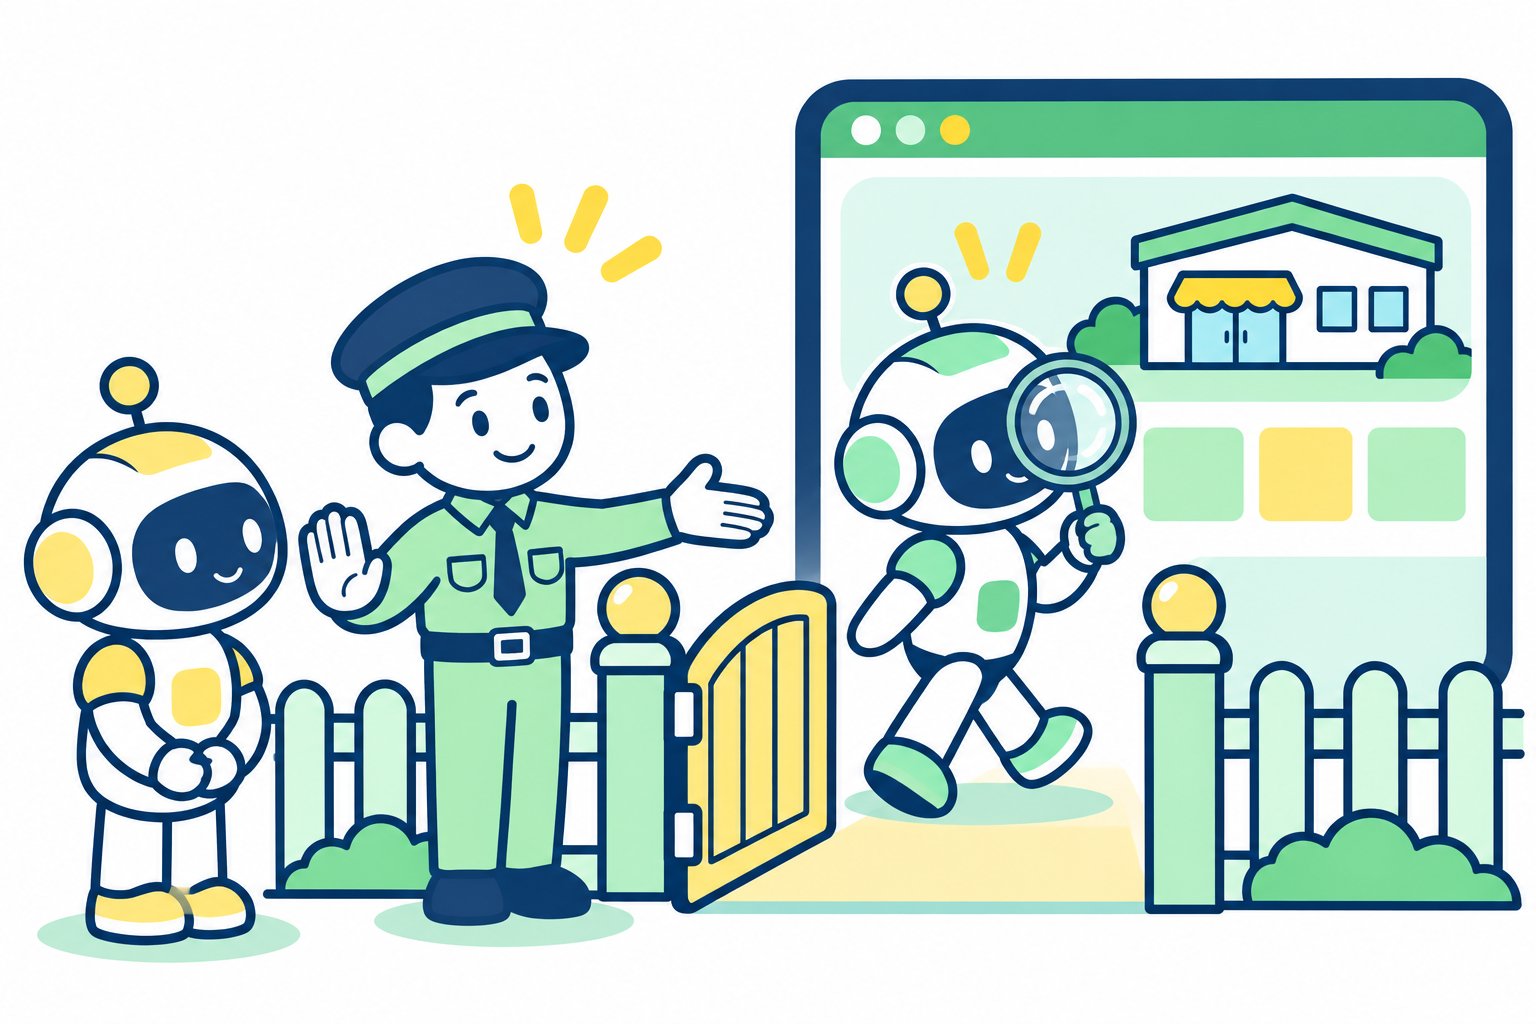
ChatGPTの検索機能では、OpenAIの「OAI-SearchBot」というクローラーがページを読みに来ます。robots.txt でこれを止めていると、ChatGPTの検索の回答には表示されません。
一方で、AIの学習に使われるかどうかは、検索とは別の設定です。OpenAIの「GPTBot」とGoogleの「Google-Extended」は、検索に出るかどうかを決めるものではありません。この3つを分けて考えると、迷わずに設定できます。
robots.txt は、クローラーに「ここは読まないで」と伝えるためのファイルです
robots.txt は、ホームページのいちばん上の階層に置かれる小さなテキストファイルです。ブラウザで「https://自社のドメイン/robots.txt」を開くと、誰でも中身を見られます。
中身は、クローラーの名前を書く「User-agent」と、読ませない場所を書く「Disallow」の組み合わせです。たとえば次のように書くと、GPTBot にはサイト全体を読ませない、という意味になります。
User-agent: GPTBot
Disallow: /
「Disallow: /」は、サイトのすべてのページという意味です。自社の robots.txt を開いて、検索に出したいクローラーの名前の下に「Disallow: /」が書かれていないかを見るのが、最初の確認になります。
なお、Googleの説明では、robots.txt が見つからない場合(404など)は、クロールの制限がないものとして扱われます。ファイルがないこと自体は、検索に出るうえでの問題にはなりません。
1つめ:GoogleのAIに出るには、ふだんの検索と同じ条件を満たしていれば十分です
Googleの「AI features and your website」のページでは、AIによる概要やAIモードにリンクとして表示されるには、ページがインデックスされていて、スニペット(検索結果の説明文)付きで表示できる状態であることが条件だと書かれています。それ以外に、追加の技術的な要件はありません。
確かめておきたいのは、次の3つです。
- robots.txt で Googlebot を止めていないか
- ページに noindex(検索に出さないための指示)が入っていないか
- nosnippet や max-snippet で、検索結果の説明文の表示を止めていないか
ページがインデックスされているかどうかは、Search Console の「URL検査」で確かめられます。Search Console の登録がまだの場合は、ホームページを公開したら、Search Consoleに登録するで手順をまとめています。
llms.txt などのAI向けのファイルは、Google検索では使われていません
AIのために llms.txt というファイルを置いたほうがよい、という話を見かけることがあります。Googleの生成AI向けのガイドでは、AI向けの新しいファイルやマークアップを作る必要はなく、Google検索はそれらを無視すると書かれています。置いても、Google検索で有利にも不利にもなりません。ほかのサービスのために用意すること自体は問題ないとされています。
2つめ:ChatGPTの検索に出るには、OAI-SearchBot を止めないようにします
OpenAIのクローラーの説明ページでは、OAI-SearchBot はChatGPTの検索機能にサイトを表示するためのものだとされています。robots.txt で OAI-SearchBot を拒否したサイトは、ChatGPTの検索の回答には表示されません。ただし、サイトへの案内のためのリンクとしては表示されることがある、とも書かれています。
robots.txt を書き換えてから、OpenAIのシステムに反映されるまでには、約24時間かかるとされています。
もうひとつ見落としやすいのが、サーバーやセキュリティの設定です。OpenAIは、robots.txt で許可するだけでなく、公開しているIPアドレスの一覧からのアクセスも許可するよう案内しています。セキュリティ用のプラグインやサーバーの設定で、ボットからのアクセスをまとめて止めている場合は、あわせて確認しておきましょう。
ChatGPT-User は、使っている人の操作でページを見に来るものです
OpenAIには、ChatGPT-User という名前のアクセスもあります。ChatGPTを使っている人の操作に応じてページを見に来るもので、自動でウェブを巡回するものではありません。人の操作によるアクセスのため、robots.txt のルールが当てはまらないことがある、と説明されています。検索に出るかどうかを決めるのは、OAI-SearchBot のほうです。
3つめ:AIの学習に使われたくないときは、GPTBot と Google-Extended を個別に止められます
GPTBot は、OpenAIの生成AIの基盤モデルの学習に使われる可能性のあるページを集めるクローラーです。robots.txt で GPTBot を拒否すると、サイトの内容を学習に使わないでほしい、という意思表示になります。
OpenAIは、それぞれの設定は独立していて、OAI-SearchBot を許可して検索には出しながら、GPTBot を拒否することもできると説明しています。
Googleの Google-Extended は、Geminiのモデルの学習や、GeminiアプリなどでGoogle検索の内容を答えに使うかどうかを管理するためのものです。Googleは、Google-Extended はGoogle検索への掲載に影響せず、順位を決める要素にも使われないと明記しています。
検索には出して、学習には使われたくない場合は、たとえば次のように書きます。
User-agent: OAI-SearchBot
Allow: /

User-agent: GPTBot
Disallow: /

User-agent: Google-Extended
Disallow: /
学習を断るかどうかは、会社ごとの考え方で決めてかまいません。まずは名前を知ってもらいたい段階なら、どれも止めないという選び方もあります。大事なのは、検索のためのクローラーまで一緒に止めてしまわないことです。
WordPressのサイトでは、表示設定とSEOプラグインもあわせて確かめます
WordPressは、robots.txt のファイルを自分で置いていなくても、自動で robots.txt を返します。中身を変えたいときは、SEOプラグインの編集画面や、サーバーに置いたファイルで書き換えます。どこで設定しているかはサイトによって違うので、分からないときは制作会社に確認してみてください。
もうひとつ見ておきたいのが、管理画面の「設定」→「表示設定」にある「検索エンジンでの表示」です。ここで「検索エンジンがサイトをインデックスしないようにする」にチェックが入っていると、検索エンジンにインデックスしないよう求める指示が出ます。制作中にチェックを入れたまま公開してしまうこともあるので、一度見ておくと安心です。
よくある質問
robots.txt がないのですが、AIの検索に出られますか?
Googleの説明では、robots.txt が見つからない場合(404など)は、クロールの制限がないものとして扱われます。ファイルがないことが原因で、Google検索やAIによる概要に出られなくなることはありません。
llms.txt は作ったほうがいいですか?
Google検索では使われていません。Googleは、AI向けの新しいファイルを作る必要はなく、Google検索はそれらを無視すると説明しています。ほかのサービスのために用意するのは自由です。
GPTBot を止めると、ChatGPTの検索に出なくなりますか?
OpenAIの説明では、OAI-SearchBot と GPTBot の設定はそれぞれ独立しています。GPTBot だけを止めて OAI-SearchBot を許可していれば、検索に出すための設定は保たれます。
robots.txt を直したら、すぐに反映されますか?
OpenAIは、robots.txt を更新してからシステムに反映されるまで約24時間かかるとしています。Googleは、検索結果での表示の制御を変えた場合、再クロールまでに数日から数か月かかることがあると説明しています。
まとめ
AIの検索に自社のホームページを出したいときは、まず robots.txt を開いて、次の3つを確かめます。
- Googlebot を止めていないか。GoogleのAIに出るための特別な対策は必要ありません
- OAI-SearchBot を止めていないか。ChatGPTの検索に出るには、これを許可しておく必要があります
- GPTBot と Google-Extended は学習のための設定で、検索に出るかどうかとは別です
自社のサイトの robots.txt の見方が分からない、どこで設定しているか分からない、というときは、お問い合わせからお気軽にご相談ください。
参考にした公式情報
- Google 検索セントラル「AI features and your website」
- Google 検索セントラル「Optimizing your website for generative AI features on Google Search」
- Google「List of Google’s common crawlers」
- Google「How Google interprets the robots.txt specification」
- OpenAI「Overview of OpenAI Crawlers」